Archive
手搓GPU(一)
GPU
Nvda暴涨了一年,GPU可太火了,但大家都缺少合适的学习资料,GitHub上有一个入门GPU的项目TinyGPU [https://github.com/adam-maj/tiny-gpu] 很适合学习。所以我手扒了全部的设计思路来供大家了解GPU的设计思路,可以在家手搓GPU玩玩。本手册基本逐行解读代码,可以不用在收藏夹吃灰了。
架构
目前CPU的架构开源的更多,但先进的GPU的low-level设计都是保密的。这个TinyGPU是目前最简单的GPU实现但也包含了GPU的工作原理。这个GPU突出的功能是并行计算「硬件加速」而不是图形化处理「渲染引擎」。
三个要点:
- 架构
- 并行处理
- 内存(突破内存带宽限制)
架构图
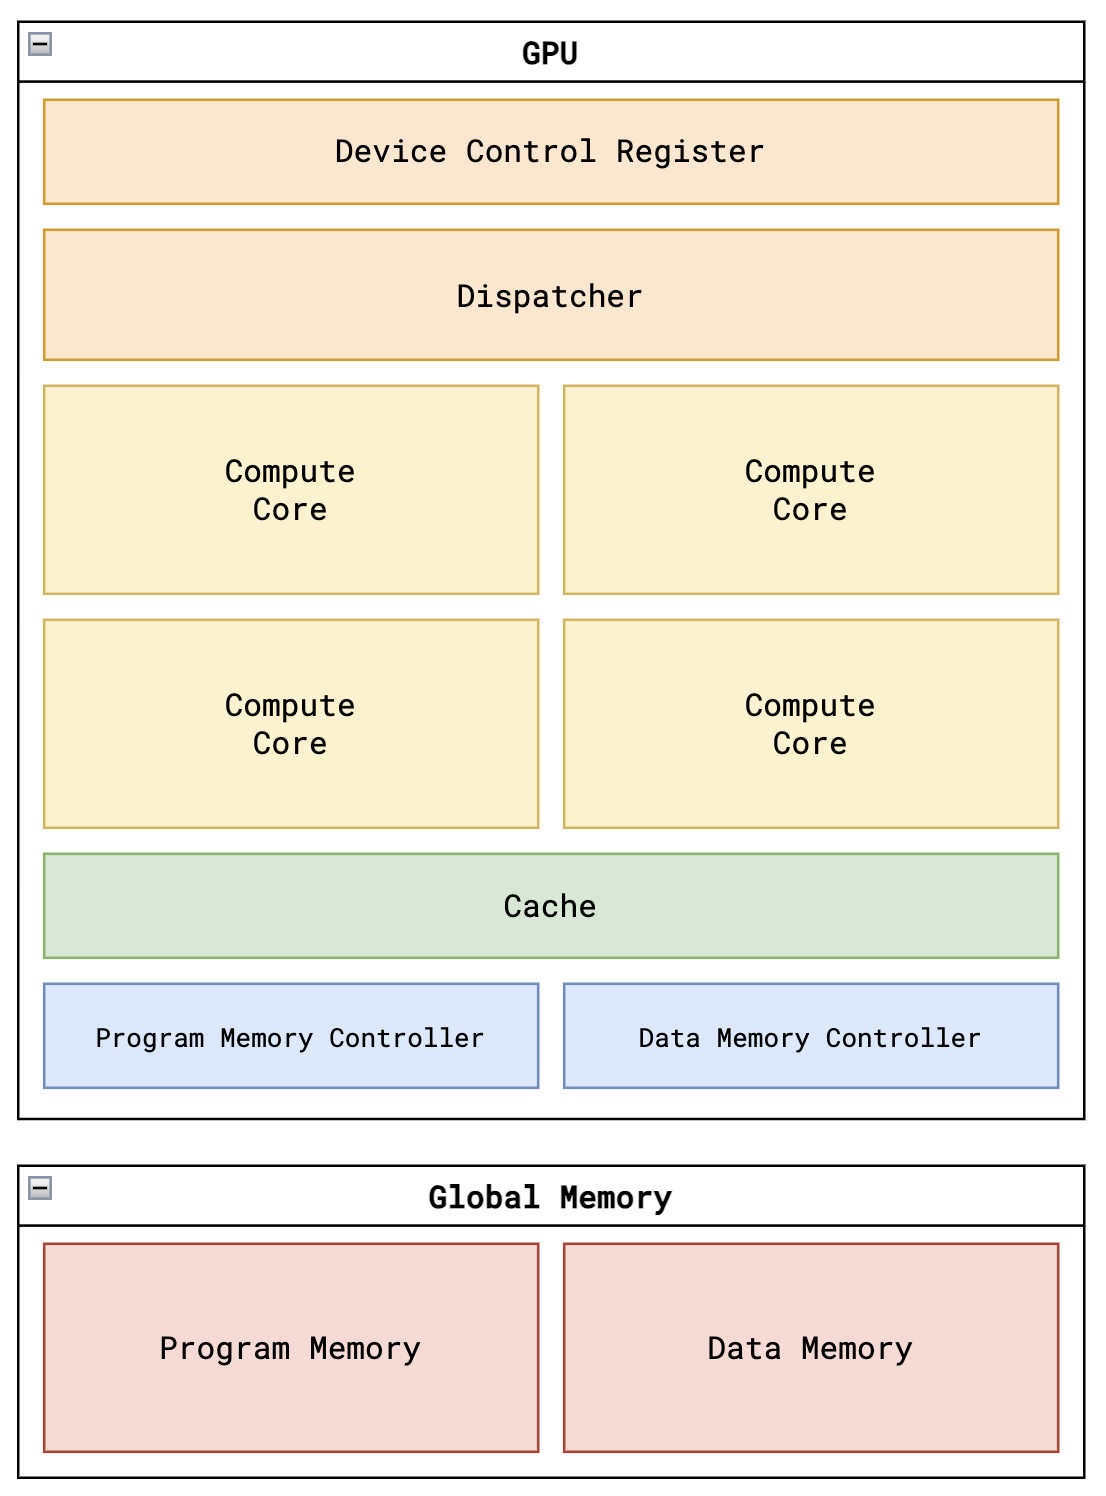
总体架构图如下:
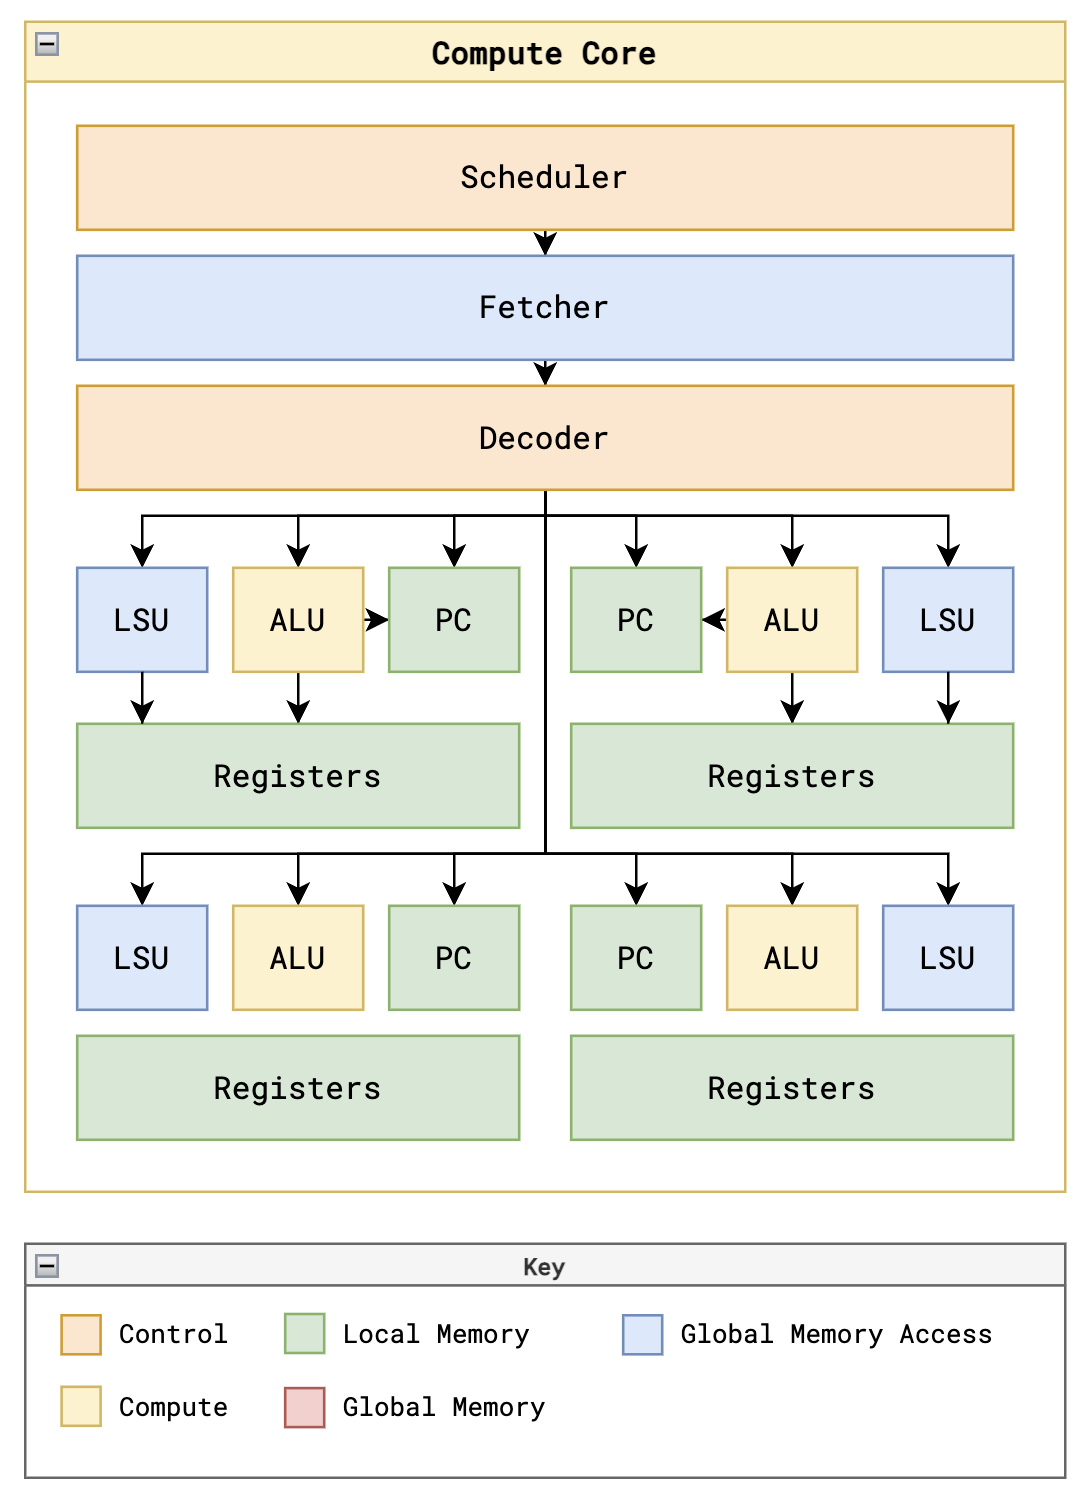
Compute Core里有:
总体运行
TinyGPU每次执行一个Core
为了启动Core,操作如下:
- 用kernel代码(也就是py写的,用的是cocotb这个协同仿真框架,和makefile协同使用)load global program memory
- 将必要的代码load进data memory里
- 在device control register里指定要启动多少thread
- 把start signal拉高来运行kernel
GPU架构里包含:
- Device Control Register
- Dispatcher
- 很多个Compute Core
- Memory Controller for Data Memory & Program Memory
- Cache
Data flow是这样的:
代码中.py都是kernel来进行仿真测试的框架,还有makefile作为脚本。
其实就是虚拟化的memory(因为我们GPU架构里只有mem的controller),还有指定程序(加减乘除)的机器码(根据ISA),时钟。相当于input和output destination。然后就是控制各个阶段运行状态和仿真后printer一些logger文件。
下面来详细讲解下各个部分和verilog代码。
Top Level
定义了很多变量,把各个部分实例化并连接到一起。
这里主要说一下core的实例化
// Compute Cores
genvar i;
generate
    for (i = 0; i < NUM_CORES; i = i + 1) begin : cores
        // EDA: We create separate signals here to pass to cores because of a requirement
        // by the OpenLane EDA flow (uses Verilog 2005) that prevents slicing the top-level signals
        reg [THREADS_PER_BLOCK-1:0] core_lsu_read_valid; // one hot
        reg [DATA_MEM_ADDR_BITS-1:0] core_lsu_read_address [THREADS_PER_BLOCK-1:0];
        reg [THREADS_PER_BLOCK-1:0] core_lsu_read_ready;
        reg [DATA_MEM_DATA_BITS-1:0] core_lsu_read_data [THREADS_PER_BLOCK-1:0];
        reg [THREADS_PER_BLOCK-1:0] core_lsu_write_valid;
        reg [DATA_MEM_ADDR_BITS-1:0] core_lsu_write_address [THREADS_PER_BLOCK-1:0];
        reg [DATA_MEM_DATA_BITS-1:0] core_lsu_write_data [THREADS_PER_BLOCK-1:0];
        reg [THREADS_PER_BLOCK-1:0] core_lsu_write_ready;

        // Pass through signals between LSUs and data memory controller
        // Load/Store Unit
        genvar j;
        for (j = 0; j < THREADS_PER_BLOCK; j = j + 1) begin
            localparam lsu_index = i * THREADS_PER_BLOCK + j;
            always @(posedge clk) begin
                lsu_read_valid[lsu_index] <= core_lsu_read_valid[j];
                lsu_read_address[lsu_index] <= core_lsu_read_address[j];

                lsu_write_valid[lsu_index] <= core_lsu_write_valid[j];
                lsu_write_address[lsu_index] <= core_lsu_write_address[j];
                lsu_write_data[lsu_index] <= core_lsu_write_data[j];

                core_lsu_read_ready[j] <= lsu_read_ready[lsu_index];
                core_lsu_read_data[j] <= lsu_read_data[lsu_index];
                core_lsu_write_ready[j] <= lsu_write_ready[lsu_index];
            end
        end

        // Compute Core
        core #(
            .DATA_MEM_ADDR_BITS(DATA_MEM_ADDR_BITS),
            .DATA_MEM_DATA_BITS(DATA_MEM_DATA_BITS),
            .PROGRAM_MEM_ADDR_BITS(PROGRAM_MEM_ADDR_BITS),
            .PROGRAM_MEM_DATA_BITS(PROGRAM_MEM_DATA_BITS),
            .THREADS_PER_BLOCK(THREADS_PER_BLOCK),
        ) core_instance (
            .clk(clk),
            .reset(core_reset[i]),
            .start(core_start[i]),
            .done(core_done[i]),
            .block_id(core_block_id[i]),
            .thread_count(core_thread_count[i]),

            .program_mem_read_valid(fetcher_read_valid[i]),
            .program_mem_read_address(fetcher_read_address[i]),
            .program_mem_read_ready(fetcher_read_ready[i]),
            .program_mem_read_data(fetcher_read_data[i]),

            .data_mem_read_valid(core_lsu_read_valid),
            .data_mem_read_address(core_lsu_read_address),
            .data_mem_read_ready(core_lsu_read_ready),
            .data_mem_read_data(core_lsu_read_data),
            .data_mem_write_valid(core_lsu_write_valid),
            .data_mem_write_address(core_lsu_write_address),
            .data_mem_write_data(core_lsu_write_data),
            .data_mem_write_ready(core_lsu_write_ready)
        );
    end
endgenerate
用到了generate,并且数量可自定义。generate虽然用到了for loop,循环的次数也没写死,但实际硬件infer时会根据实际定义的核心数量进行生成,生成真实的网表。
在实例化core中,我们GPU是有多个core,每个core里也有多个thread的。所以一个简单的double loop。
LSU是Load & Store Unit,每个thread有单独的LSU,这里localparam lsu_index = i * THREADS_PER_BLOCK + j; 是因为 i 表示 core的index,j 表示 thread的index,比如 有2个core,每个core里4个thread
第一个core里:
core[0] thread[0] LSU[0]
core[0] thread[1] LSU[1]
core[0] thread[2] LSU[2]
core[0] thread[3] LSU[3]
那么第二个core就需要重新分配LSU的index了,因为LSU就那一个信号通道:
i * THREADS_PER_BLOCK + j = 1 * 4 + 0 = 4
core[1] thread[0] LSU[4]
core[1] thread[1] LSU[5]
core[1] thread[2] LSU[6]
core[1] thread[3] LSU[7]
// Compute Cores
genvar i;
generate
for (i = 0; i < NUM_CORES; i = i + 1) begin : cores
     // EDA: We create separate signals here to pass to cores because of a requirement
     // by the OpenLane EDA flow (uses Verilog 2005) that prevents slicing the top-level signals
     reg [THREADS_PER_BLOCK-1:0] core_lsu_read_valid; // one hot
     reg [DATA_MEM_ADDR_BITS-1:0] core_lsu_read_address [THREADS_PER_BLOCK-1:0];
     reg [THREADS_PER_BLOCK-1:0] core_lsu_read_ready;
     reg [DATA_MEM_DATA_BITS-1:0] core_lsu_read_data [THREADS_PER_BLOCK-1:0];
     reg [THREADS_PER_BLOCK-1:0] core_lsu_write_valid;
     reg [DATA_MEM_ADDR_BITS-1:0] core_lsu_write_address [THREADS_PER_BLOCK-1:0];
     reg [DATA_MEM_DATA_BITS-1:0] core_lsu_write_data [THREADS_PER_BLOCK-1:0];
reg [THREADS_PER_BLOCK-1:0] core_lsu_write_ready;这里前半部分必须要定义一些全局变量,原因:reusable、用来slice signal、同步每个信号的时钟
对于slice signal,因为 比如valid信号 每个core里的每个thread其实就一位,我们这里用one hot,后面在连接core的pin时里我们连接每个valid 要把对应的那位提出来 .program_mem_read_valid(fetcher_read_valid[i]),。这就是slice。所以不能把最顶层的全局信号(top-level signals)直接传进去。
// Pass through signals between LSUs and data memory controller
// Load/Store Unit
genvar j;
for (j = 0; j < THREADS_PER_BLOCK; j = j + 1) begin
    localparam lsu_index = i * THREADS_PER_BLOCK + j;
    always @(posedge clk) begin
        lsu_read_valid[lsu_index] <= core_lsu_read_valid[j];
        lsu_read_address[lsu_index] <= core_lsu_read_address[j];

        lsu_write_valid[lsu_index] <= core_lsu_write_valid[j];
        lsu_write_address[lsu_index] <= core_lsu_write_address[j];
        lsu_write_data[lsu_index] <= core_lsu_write_data[j];

        core_lsu_read_ready[j] <= lsu_read_ready[lsu_index];
        core_lsu_read_data[j] <= lsu_read_data[lsu_index];
        core_lsu_write_ready[j] <= lsu_write_ready[lsu_index];
    end
end
这里就是一个always块把这些信号先时钟对齐一下。
然后就是pin和pin的连接,没什么了。